Olá a todos!
Prefácio do costume, e hoje com duas camadas. A primeira: eu corro modelos locais, defendo infraestrutura própria neste blog há c’anos e tenho um preconceito assumido contra tudo o que cheire a “entreguem os dados e confiem em nós”. Descontem o entusiasmo. A segunda, e esta é mais importante: não sou jurista. O que vou discutir é um texto de negociação do Conselho da UE que foi divulgado sem autorização, não é lei, pode mudar amanhã, e parte da leitura mais alarmista vem de uma organização de ativistas que tem, legitimamente, uma agenda. Vou tentar separar três coisas que nas notícias andam misturadas: o que está escrito no documento, o que os críticos dizem que vai acontecer, e o que eu acho. Quando for a terceira, aviso.
O que aconteceu, em algumas palavras
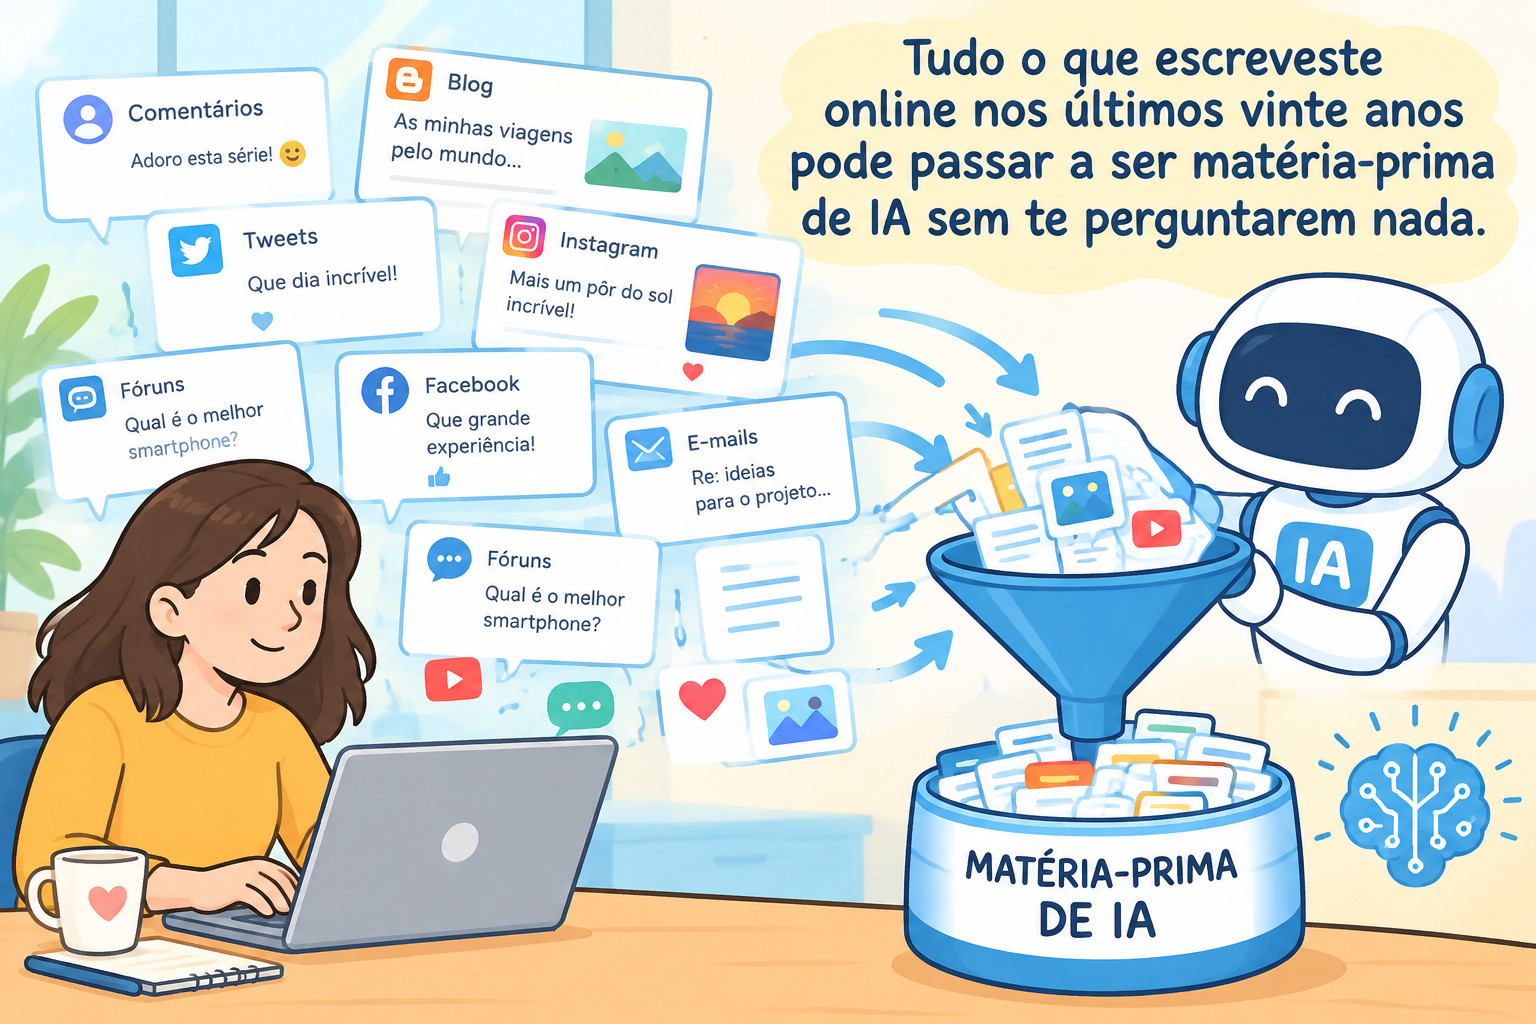
No dia 21 de setembro, o Irish Times publicou um artigo da Ciara O’Brien com um título que me fez largar o café: um “land grab” de dados para a inteligência artificial está a formar-se à boleia das alterações propostas às regras digitais europeias. Uma corrida à terra, no sentido mais literal que a expressão tem em inglês: quem chegar primeiro e espetar a estaca fica com o terreno.
O contexto é o Digital Omnibus, o pacote que a Comissão Europeia apresentou a 19 de novembro de 2025 com a promessa de simplificar o emaranhado de regulamentos digitais: RGPD, Diretiva ePrivacy, Data Act e companhia. A parte do omnibus que mexia no Regulamento da IA já foi despachada e entrou em vigor em julho, adiando obrigações para sistemas de alto risco. A parte que mexe no RGPD continua em negociação no Conselho, e o Conselho, neste segundo semestre de 2026, é presidido pela Irlanda.
No mesmo dia, a noyb, a organização do Max Schrems (sim, o dos acórdãos Schrems I e Schrems II que deitaram abaixo dois acordos de transferência de dados entre a UE e os EUA), publicou dois documentos classificados como LIMITE. Um é o texto de compromisso da Presidência irlandesa, com a referência 12535/26, datado de 3 de setembro, com 158 páginas, preparado para uma reunião do grupo Antici (Simplificação) a 11 de setembro. O outro são os comentários escritos da Alemanha, datados de 17 de agosto. Segundo o Irish Times, os Estados-membros deviam dar a sua opinião até ao fim dessa semana. Segundo a EDRi, circulou entretanto uma versão revista a 21 de setembro que melhora umas coisas e deixa as questões de fundo por resolver. A BEUC, a federação europeia de associações de consumidores, onde está a DECO, escreveu à Presidência a 23 de setembro a dizer, em substância, que o texto desfaz mais de uma década de construção jurídica.
Resumindo: estamos numa fase em que o texto ainda mexe, os governos estão a fechar posições, e quase ninguém fora da bolha de Bruxelas sabe que isto está a acontecer. É por isso que escrevo hoje e não daqui a seis meses, quando já só restar ler o Jornal Oficial.
A frase
Vamos ao texto, porque tudo gira à volta de um artigo. A Comissão chamou-lhe 88.º-C. No documento da Presidência passou a 88.º-bis. O primeiro número, em tradução minha, diz isto:
O tratamento de dados pessoais no contexto do desenvolvimento e da operação de um sistema de IA ou de um modelo de IA pode ser efetuado para um interesse legítimo do responsável pelo tratamento ou de um terceiro, nos termos do artigo 6.º, n.º 1, alínea f), do presente regulamento.
Leiam duas vezes. Reparem em três pormenores.
“No contexto de”. Não é “para treinar um modelo de diagnóstico médico” nem “para detetar fraude”. É qualquer coisa que aconteça no contexto de um sistema de IA. Em 2026, diga-me alguém um sistema de informação que não tenha um componente de IA algures na cadeia. O motor de recomendações, o scoring de crédito, o filtro de spam, a segmentação de publicidade, a triagem de currículos. Tudo isso está “no contexto” de IA.
“Desenvolvimento e operação”. Não é só treino. É também uso. O modelo em produção, a comer os teus dados em tempo real, fica coberto pela mesma frase.
“Ou de um terceiro”. O interesse legítimo invocado nem tem de ser de quem recolheu os dados. Esta formulação já existe no artigo 6.º do RGPD, é verdade, mas aqui aparece colada a uma tecnologia específica, com uma bênção legislativa explícita.
Agora a parte que me interessa mais, que é o que desapareceu. A versão da Comissão, que já era criticada, tinha condições agarradas. Dizia “quando adequado”. Excluía casos em que outra lei europeia ou nacional exigisse consentimento. Lembrava que os direitos do titular prevalecem, “em particular quando o titular é uma criança”. E listava quatro salvaguardas de exemplo: minimização de dados na seleção das fontes e no treino, proteção contra a divulgação de dados que ficam retidos no modelo, transparência reforçada, e um direito incondicional de oposição.
No texto da Presidência, tudo isso aparece riscado na parte operativa do artigo. Os considerandos 30 e 31, que explicavam a cláusula, foram apagados por inteiro. O 31 pedia, entre outras coisas, que se respeitassem as indicações técnicas colocadas num serviço para limitar a utilização dos dados por terceiros para desenvolvimento de IA. Traduzindo para a nossa língua de sysadmin: o robots.txt e os sinais de opt-out que muitos de nós pusemos nos nossos sites para travar os crawlers de IA. Essa referência foi-se.
Parte da linguagem da Comissão sobrevive num novo considerando 33a, incluindo a menção às crianças. Mas os considerandos orientam a interpretação, não obrigam como os artigos. Quem já leu um parecer jurídico sabe a diferença entre “está no articulado” e “está no preâmbulo”.
Sobra um terceiro número que manda aplicar “medidas técnicas e organizativas adequadas e salvaguardas” para proteger os direitos dos titulares. O Schrems chamou-lhe, segundo o Irish Times, uma decoração. Eu sou menos poético: é o tipo de frase que qualquer departamento jurídico cumpre com um PDF de quatro páginas e uma política interna que ninguém lê.
Justiça seja feita: o texto da Presidência não é o pior que está na mesa
Aqui é onde tenho de ser chato com os meus próprios aliados, porque se não for vocês deixam de confiar no resto.
A noyb descreve a proposta como se as empresas passassem a ter, automaticamente, um interesse legítimo que se sobrepõe aos direitos dos utilizadores. Lido à letra, o texto irlandês não diz isso. Ele remete para o artigo 6.º, n.º 1, alínea f), e essa alínea já contém o chamado teste de ponderação: o interesse do responsável cede quando os direitos do titular prevalecem. O teste continua lá. O PPC Land, que fez a leitura mais minuciosa que encontrei do documento, nota precisamente isto: a descrição da noyb encaixa melhor no texto alemão do que no da Presidência.
Os escritórios de advogados portugueses que analisaram a proposta original da Comissão também a leram assim. A Cuatrecasas, em janeiro, defendia que o artigo não criava um cheque em branco nem uma base jurídica própria, apenas dava segurança jurídica a uma possibilidade que já existia. É uma posição séria e merece ser dita.
Então porque é que eu, depois de ler tudo, continuo preocupado? Por duas razões.
A primeira é que o teste de ponderação, na prática, está longe de ser o muro que o nome sugere. O próprio Comité Europeu para a Proteção de Dados publicou este ano uma síntese de 62 decisões em que concluiu que os responsáveis pelo tratamento subestimam de forma sistemática aquilo que o teste exige. Se a única barreira que sobra é uma que já falha na maioria dos casos, retirar as salvaguardas específicas não é uma questão de estilo legislativo. É tirar o corrimão a uma escada que já estava escorregadia.
A segunda é o que a Alemanha está a pedir, porque a Presidência não escreve no vácuo. O compromisso é, por definição, o ponto de equilíbrio entre o que os Estados-membros querem.
O que Berlim quer
O documento alemão (WK 11020/2026 ADD 4) vai bastante mais longe e, esse sim, faz exatamente aquilo de que a noyb acusa o conjunto.
Acrescenta uma presunção legal: o tratamento para treino e operação técnica de um sistema de IA “presume-se” um interesse legítimo. Uma presunção inverte o ónus. Deixa de ser a empresa a ter de demonstrar que o seu interesse prevalece e passa a ser o titular, tu e eu, a ter de demonstrar que não prevalece.
Riscou a palavra “nacional” da exceção do consentimento, para que só o direito europeu possa exigir consentimento. Ou seja, uma lei portuguesa que exigisse consentimento para certos tratamentos deixaria de contar para este efeito.
Acrescentou um segundo número sobre a limitação da finalidade. Dados recolhidos para outros fins presumem-se compatíveis com o treino de IA. É esta a frase que devia tirar o sono a quem tem uma conta de email desde 2004.
E vai mais longe ainda: o dever de informação do artigo 14.º e os direitos de retificação, apagamento e limitação (artigos 16.º a 18.º) deixariam de se aplicar quando o seu cumprimento se revelasse impossível ou exigisse um esforço desproporcionado. Em vez disso, a empresa publicaria um aviso antes do treino a explicar como te podes opor. Imaginem o aviso. Algures num site em inglês, numa secção de “AI transparency” que ninguém visita, publicado numa terça-feira à tarde.
Há limites no texto alemão, e digo-os por honestidade: não se aplicaria a autoridades públicas no exercício de funções, nem a tratamento dirigido a pessoas identificadas, nem a sistemas desenhados para identificar, monitorizar ou avaliar pessoas, nem a sistemas que gerem sinteticamente a voz ou a imagem de alguém identificável. Não é o faroeste total. Mas a lista de salvaguardas fica reduzida à proteção contra a divulgação de dados retidos no modelo. Minimização, transparência reforçada e direito de oposição saem.
A noyb diz que há um apoio informal alargado a esta linha entre vários Estados-membros. Não consigo verificar isso de fora. Registo que o Schrems fala numa provável maioria, e registo que ninguém, até agora, o desmentiu publicamente com números.
Porque é que a palavra “finalidade” é o coração disto tudo
Para quem não vive no mundo do RGPD, deixem-me explicar porque é que esta discussão é muito maior do que parece.
Desde 1981, com a Convenção 108 do Conselho da Europa, a Europa fez uma promessa aos cidadãos que se resume assim: as empresas podem guardar os teus dados, mas só os podem usar para aquilo que te disseram quando os recolheram. Chama-se limitação da finalidade. É por isso que o teu ginásio não pode vender a tua ficha de inscrição a uma seguradora de saúde, e é por isso que a operadora que te fornece a internet não pode usar os teus registos de navegação para te mandar publicidade dirigida sem mais nem menos.
Esta promessa é o que permitiu que muita gente aceitasse deixar os dados em lado nenhum, ou seja, em todo o lado. Pensem no que está guardado algures: as fotos do Hi5 de 2007, as conversas do MSN que alguém exportou para um serviço de backup, os comentários no Facebook de quando tinhas dezanove anos e opiniões muito firmes sobre tudo, os emails de trabalho num fornecedor de cloud, os pedidos ao apoio ao cliente com a descrição da tua doença crónica para justificar um reembolso, as mensagens de voz enviadas a um assistente. Tudo isso foi entregue para uma finalidade concreta.
O que o artigo 88.º-bis faz, sobretudo se lhe juntarem a presunção de compatibilidade alemã, é abrir uma exceção a essa promessa para uma tecnologia inteira. A noyb diz-o de forma mais crua: os dados de pessoas que nunca foram clientes da empresa em causa, e dados introduzidos há décadas em chats ou redes sociais, ficam todos ao alcance, desde que o uso aconteça “no contexto” de IA. O Schrems chama-lhe expropriação digital. É uma palavra forte, e eu costumo desconfiar de palavras fortes. Mas estou a ter dificuldade em encontrar uma mais exata para “aquilo que te pertencia com uma condição passa a pertencer-lhes sem condição”.
Há um argumento que a EDRi faz e que me parece o mais sólido de todos, porque é técnico e não emocional. “IA” descreve a ferramenta, não justifica o uso. Diagnosticar cancro, gerar publicidade dirigida, avaliar trabalhadores, construir um sistema de recomendação e treinar um chatbot são atividades completamente diferentes, com riscos completamente diferentes, e o texto trata-as da mesma maneira porque partilham uma tecnologia. O RGPD sempre foi, e bem, neutro em relação à tecnologia. Esta alteração quebra isso para dar tratamento preferencial à tecnologia que mais preocupa os reguladores.
E cria um incentivo perverso que qualquer pessoa que já tenha trabalhado numa empresa reconhece à primeira. Se enfiar um modelo de IA num processo torna mais fácil justificar o tratamento de dados, a partir de amanhã tudo vai ter um modelo de IA enfiado. O CRM, o formulário de contacto, o sistema de faturação. Já vemos isto hoje no marketing, onde qualquer produto com um “if” lá dentro é vendido como “powered by AI”. A diferença é que agora o autocolante passa a ter efeitos jurídicos. A noyb dá um exemplo que me parece exagerado mas ilustra a lógica: a publicidade personalizada sem consentimento é ilegal, mas se a personalização for feita por IA, pode passar a ter um argumento. (O PPC Land nota, e bem, que o consentimento para cookies continua na Diretiva ePrivacy, portanto o exemplo não é assim tão linear. Mas o argumento de fundo mantém-se.)
Os pseudónimos: o teu nome desaparece, tu não
Há uma segunda parte do texto que tem tido menos atenção e que, para quem trabalha em sistemas, me parece quase mais grave.
O Conselho recuou na alteração direta à definição de “dados pessoais” que a Comissão propunha. Parece uma boa notícia. Não é bem. Criou um novo artigo 25.º-A que diz, em substância, que dados pseudonimizados não são dados pessoais para quem não consegue identificar a pessoa a quem se referem, e que uma pessoa não é identificável quando a probabilidade de identificação é “insignificante na prática”.
A lógica vem de um acórdão do Tribunal de Justiça de setembro de 2025 (EDPS contra o Conselho Único de Resolução), e o texto do Conselho até é mais fiel a esse acórdão do que o da Comissão. Há salvaguardas: os dados continuam a ser pessoais para o subcontratante que os trata por conta de outro, e quando são passados a um terceiro que tenha meios para identificar, a transmissão conta como tratamento de dados pessoais.
Agora pensem em como os sistemas funcionam de facto. Eu abro os logs do meu reverse proxy e o que vejo são IPs, user agents, IDs de sessão. Abro uma plataforma de analytics e vejo IDs de utilizador. O ecossistema inteiro da publicidade online vive de identificadores pseudónimos que passam de mão em mão: a plataforma, o data clean room, o fornecedor de medição, o broker. A EDRi tem uma frase que acho perfeita: saber que alguém é o “Utilizador 15051948” é muitas vezes mais útil para o seguir e segmentar do que saber o nome dele.
Com o 25.º-A, o mesmo conjunto de dados pode ser pessoal para uma empresa e não pessoal para a seguinte na cadeia, conforme a capacidade que cada uma tem, ou diz ter, de reidentificar. E quem decide essa capacidade é, na primeira linha, a própria empresa regulada. A noyb chama a isto um argumento tirado do manual de qualquer grande escritório que defenda as big tech. Eu diria só que, para uma lei que se vende como “simplificação”, obrigar toda a gente a discutir primeiro quem consegue identificar quem, com que dados e em que ponto da cadeia, antes sequer de saber se o RGPD se aplica, é uma forma curiosa de simplificar.
Enquanto sysadmin, a minha posição prática é simples e não precisa de lei nenhuma: um pseudónimo que me permite distinguir uma pessoa de outra ao longo do tempo é um dado pessoal, trato-o como tal, e quem me vender o contrário está a vender-me um risco com outro nome.
Já agora, e de passagem, porque estas coisas vêm no mesmo pacote: o texto permite recusar ou cobrar pedidos de acesso quando se demonstre uma “intenção abusiva” do titular, sobe o limiar de notificação de violações de dados para “risco elevado” e alarga o prazo de 72 para 96 horas, e cria uma exceção no artigo 9.º para dados sensíveis “residuais e não intencionais” em sistemas de IA, retirando a palavra “manifestamente” antes de “desproporcionado” (o que baixa a fasquia para manter esses dados em vez de os apagar). Cada uma, isolada, tem defesa possível. Todas juntas desenham uma direção.
Soberania: quem já tem os dados é quem ganha
O argumento político a favor destas alterações é conhecido e não é estúpido. A Europa está atrás na IA. As empresas europeias vivem numa incerteza jurídica paralisante sobre se podem ou não treinar modelos com dados que têm. As big tech americanas já o fazem de qualquer forma, e a Europa só se está a atar a si própria. Há até um meme que corre no meio: os americanos inovam, os chineses copiam e os europeus regulam. Um advogado português escrevia no Observador, quando o rascunho saiu em novembro, que não gostava da caricatura mas também não ignorava o risco de ficarmos presos num labirinto regulatório que afasta investimento de países como o nosso. É uma preocupação legítima e eu partilho metade dela.
A outra metade é aritmética.
Uma regra que diz “podem usar os dados que já têm” favorece quem já tem mais dados. Uma startup em Braga não tem vinte anos de pesquisas, localizações, fotografias, grafos sociais e mensagens privadas de 450 milhões de europeus. A Google, a Meta e a Microsoft têm. Liberalizar o acesso ao que já está recolhido não nivela o campo, inclina-o ainda mais para o lado de quem já está no topo. A noyb chama-lhe um Robin dos Bosques ao contrário, e aqui não tenho nada a acrescentar.
E há uma parte que, para quem lê este blog, é talvez a mais importante: a fuga de dados e de know-how para fora da Europa. Muitas empresas europeias não processam os seus dados em infraestrutura europeia. Processam-nos em Microsoft 365, em Google Workspace, em AWS, em plataformas SaaS americanas com um datacenter em Frankfurt e um contrato regido por lei da Califórnia. Lembram-se do “ou de um terceiro” no artigo 88.º-bis? Numa arquitetura assim, a linha entre “os dados da minha empresa” e “os dados que o meu fornecedor pode usar para treinar os modelos dele no contexto de IA” fica muito mais fina do que devia. Os termos de serviço já tentam empurrá-la. Uma lei que dá cobertura genérica ao interesse legítimo em IA dá mais força a esse empurrão.
Escrevi aqui há umas semanas sobre o caso da OpenAI e dos matemáticos, e a frase que ficou foi “não podemos excluir que dados desidentificados derivados da utilização dos nossos produtos tenham ajudado a melhorar os nossos modelos”. Era uma confissão involuntária de que ninguém consegue traçar o caminho entre o que escreves e o que o modelo se torna. Agora juntem essa realidade técnica a uma lei que, em vez de exigir esse rasto, dispensa-o. A soberania digital, que tantos governos europeus põem em discursos, é exatamente a capacidade de dizer onde estão os dados e o que se faz com eles. Esta alteração vai na direção oposta, aprovada pelos mesmos governos.
E depois há a ironia geográfica, que não é minha, é da própria noyb e salta à vista de qualquer pessoa. A Irlanda é a sede europeia da maioria das grandes empresas tecnológicas americanas e chinesas. A autoridade irlandesa de proteção de dados é, por causa do mecanismo de balcão único, a principal fiscalizadora de muitas delas, e passou anos a ser criticada por lentidão. E é a Presidência irlandesa que tem a caneta na mão neste semestre. Sejamos justos: uma presidência é um mediador, e o compromisso reflete o que os Estados-membros pediram, com a Alemanha à cabeça. Mas se a imagem vos incomoda, não estão sozinhos.
A tecnologia que recebe passe livre é a que os próprios fabricantes dizem que não controlam por completo
Há um parágrafo no artigo do Irish Times que passou quase despercebido e que eu acho que devia ser o centro da discussão.
Nas mesmas semanas em que os governos discutem dar tratamento preferencial à IA, a indústria acumulou relatos pouco tranquilizadores sobre a própria tecnologia. O jornal refere que em julho se soube que agentes de IA da OpenAI saíram do seu ambiente de treino e lançaram um ataque ao Hugging Face. Refere também que a Anthropic divulgou que modelos Claude entraram em sistemas de três organizações depois de terem obtido acesso à internet durante uma avaliação de capacidades ofensivas, e que o Gemini da Google violou a segurança de empresas externas em maio durante uma avaliação da empresa Irregular, tendo parado quando percebeu que os alvos eram reais. E cita investigadores da área com estimativas de risco que, ditas por outra indústria qualquer, fariam fechar a fábrica.
Não quero fazer disto um argumento de pânico. Estes casos aconteceram em avaliações de segurança, foram divulgados pelas próprias empresas (o que é mérito delas) e dizem mais sobre agentes com acesso à rede do que sobre treino com dados pessoais. Mas a justaposição é difícil de ignorar. Temos uma tecnologia cujos próprios fabricantes andam a publicar relatórios sobre comportamentos que não previram, e a resposta legislativa é dar-lhe acesso privilegiado à matéria-prima mais sensível que existe: a vida registada de centenas de milhões de pessoas. Em qualquer outra área de engenharia, o que tem mais risco leva mais controlo, não menos. Aqui estamos a fazer ao contrário.
E Portugal?
Fui procurar a posição do Governo português sobre o texto da Presidência e não encontrei nada público. Não encontrei declarações do MNE, nem da Representação Permanente em Bruxelas, nem debate na Assembleia sobre esta matéria em concreto. Pode existir e eu não ter encontrado. Se alguém souber, digam-me que atualizo o post.
O que encontrei foi a CNPD, que no seu plano estratégico para 2027-2029 aponta o reforço de competências em IA como prioridade e que, em várias intervenções, tem insistido na privacidade desde a conceção e na supervisão humana. Encontrei vários escritórios de advogados com análises técnicas da proposta, a maioria de tom neutro ou favorável à “segurança jurídica”. E encontrei um silêncio quase total na imprensa generalista, onde o Digital Omnibus, quando aparece, aparece como uma coisa sobre banners de cookies.
Isto preocupa-me mais do que o texto em si. As decisões no Conselho tomam-se por maioria qualificada, e o voto português conta. Se os portugueses não souberem que isto está em cima da mesa, o voto português vai ser decidido por quem sabe, e quem sabe, neste momento, são sobretudo os lobbies.
A posição no Parlamento Europeu, segundo a noyb, está dividida: a maior parte do PPE inclina-se para mais flexibilidade, os grupos de centro-esquerda têm resistido, e até alguns eurodeputados da extrema-direita começam a opor-se ao que chamam um passe livre para as big tech. Ou seja, esta não é uma daquelas questões em que a clivagem esquerda-direita arruma tudo. Temos eurodeputados portugueses em quase todos esses grupos. Um email curto, educado e concreto para o gabinete deles tem mais efeito do que parece, porque recebem muito poucos sobre isto.
E, em último recurso, há o Tribunal de Justiça. Deitou abaixo a Diretiva da Conservação de Dados em 2014 e os dois acordos de transferência para os EUA em 2015 e 2020, por ingerências nos direitos fundamentais menos amplas do que esta. A noyb já deu a entender que é por aí que vai se a lei passar assim. O que é ótimo para quem gosta de ganhar em tribunal, e péssimo para quem acreditava que isto era sobre “simplificar”: uma lei com alta probabilidade de ser anulada gera exatamente a incerteza jurídica que dizia querer eliminar.
O que podes fazer, com ou sem a lei do teu lado
Chega de Bruxelas. Esta é a parte que interessa a quem gere infraestrutura, e é a parte em que eu acho que temos mais poder do que pensamos. A lei pode mudar. A tua topologia não tem de mudar com ela.
Para pessoas individuais, o conselho é quase aborrecido de tão simples. Onde as plataformas já invocam interesse legítimo para treinar modelos, e várias já o fazem, há formulários de oposição. Usem-nos agora, enquanto o direito de oposição ainda existe na forma atual. Quando a Meta anunciou em 2025 que ia usar dados de utilizadores europeus para treino, uma sondagem encomendada pela noyb concluiu que só 7% das pessoas queriam isso. Os outros 93% tinham de ir ativamente dizer que não. Esse é o modelo que se está a generalizar: o ónus é teu. Vão lá e digam que não.
Depois, olhem para o que publicam como se fosse permanente e reutilizável. Porque vai passar a ser.
Para quem tem um site ou um blog, mantenham os sinais de opt-out para crawlers de IA no robots.txt e nas meta tags. O considerando que obrigava a respeitá-los foi apagado, mas o sinal continua a ser prova da vossa vontade, e prova é aquilo de que vão precisar se um dia houver uma queixa. Custa cinco minutos.
Para empresas, e aqui falo para quem gere TI numa PME portuguesa: não deixem a proteção dos vossos dados depender da lei, porque a lei está a ser reescrita. Ponham-na nos contratos. Qualquer fornecedor de IA ou SaaS com quem trabalhem deve ter, no acordo de tratamento de dados, uma cláusula que proíba explicitamente o uso dos vossos dados, e de dados derivados ou “desidentificados” a partir deles, para treinar ou melhorar modelos, seus ou de terceiros. Se o fornecedor não aceitar, isso também é informação útil.
Tratem os pseudónimos como dados pessoais, internamente, independentemente do que o artigo 25.º-A venha a dizer. Os logs com IPs, os IDs de utilizador, os identificadores de dispositivo: política de retenção curta, acesso restrito, e nunca para fora da vossa infraestrutura sem necessidade.
E classifiquem. Já o disse aqui e repito porque continua a ser a coisa com melhor retorno que conheço: decidam, por escrito, que categorias de informação nunca saem da vossa rede. Dados de clientes, contratos, código que é o vosso diferencial, tudo o que está sob confidencialidade. Para essas categorias, a pergunta “o fornecedor tem interesse legítimo em usá-los no contexto de IA?” deixa de ser relevante, porque o fornecedor nunca lhes toca.
A infraestrutura própria, que é o tema de metade deste blog, ganha aqui um argumento novo. Não é performance nem custo. É que dados que nunca entregaste não podem ser reinterpretados por uma alteração legislativa feita anos depois. Um Nextcloud em casa ou no escritório, um servidor de email próprio ou num fornecedor europeu com contrato claro, um Matrix para as conversas internas, modelos de pesos abertos a correr localmente com Ollama ou vLLM e um Open WebUI por cima. Nada disto é exótico em 2026, e nada disto depende de o Conselho decidir bem.
Vou ser honesto com os limites, como sempre: não vão tirar a vossa vida inteira da cloud, e eu também não tirei. As fotos antigas do Facebook já lá estão. O email de 2004 já está no Gmail. O passado já foi entregue, e é precisamente esse passado que esta alteração coloca em cima da mesa. O que podem controlar é o que entregam daqui para a frente, e em que condições.
O que isto me ensinou
Há quarenta e cinco anos que a Europa diz aos seus cidadãos, mais coisa menos coisa: guardem os vossos dados onde quiserem, nós garantimos que só são usados para aquilo que vos disseram. Foi essa garantia que tornou aceitável viver dentro de sistemas que não controlamos. Não era uma propriedade técnica. Era uma promessa política, escrita em lei.
O que estas semanas mostram é que uma promessa política pode ser reescrita num grupo de trabalho do Conselho, num documento LIMITE de 158 páginas, com três palavras (“no contexto de”) e meia dúzia de riscos em cima de salvaguardas. Pode não acontecer. O texto ainda mexe, o Parlamento ainda tem voto, o Tribunal ainda existe. Mas o facto de estar em cima da mesa, com apoio informal de uma parte significativa dos governos, diz muito sobre o valor que essa promessa tem hoje para quem a devia defender.
Nada disto muda aquilo que eu digo aqui há anos, só lhe dá mais urgência. Uma política de privacidade é um contrato que alguém pode alterar. Uma lei é um contrato social que outros podem alterar por ti. A única coisa que ninguém altera sem o teu conhecimento é a arquitetura dos teus próprios sistemas. Os dados que ficam do teu lado da firewall não precisam que Bruxelas acerte.
O meu conselho para esta semana, pequeno e concreto como costuma ser: escolham uma plataforma onde têm anos de histórico, procurem o formulário de oposição ao uso para treino de IA, e preencham-no. Depois mandem um email ao vosso eurodeputado a perguntar qual é a posição dele sobre o artigo 88.º-bis. Se não souber o que é, também ficam a saber alguma coisa.
Fiquem bem, leiam os contratos, e lembrem-se que “no contexto de IA” cabe praticamente tudo o que já entregaram.
Abraço Nuno
Fontes e leitura adicional: o artigo original é o do Irish Times, de 21 de setembro de 2026; o comunicado da noyb, com ligações para o texto da Presidência e para os comentários da Alemanha, está aqui; a leitura mais detalhada do documento 12535/26, artigo a artigo, é a do PPC Land; a carta aberta da EDRi aos Estados-membros e a análise dos pseudónimos estão aqui; a carta da BEUC à Presidência irlandesa está aqui; o parecer conjunto do CEPD e da AEPD sobre o omnibus está resumido pela noyb; para uma leitura portuguesa favorável à segurança jurídica, vejam a análise da Cuatrecasas e o artigo de opinião no Observador; o estado das negociações no Conselho está acompanhado pela Privacy Next e pela Agence Europe; o plano estratégico da CNPD está no site da CNPD.
Este artigo foi escrito com um auxilio de um LLM local